たった1文でAIドライバーが渋滞にはまる
少数の共通モデルの上に作られたAIエージェントが、多くの人々に代わって行動する場面が増えている。東京大学のTakahiro Ezaki、Naoto Imura、Katsuhiro Nishinariは、そうしたエージェントの多くが同じメッセージ、とくに他の全員がどう行動するかについての予測を受け取ったら何が起こるのかを知りたいと考えた。そうした予測は、いったん配信されると、それが描写する状況そのものを変え、自らの予測を裏切ることがある。
これを検証するために、彼らは人々が限られた資源を奪い合う最も単純な場面の一つを選んだ。通勤である。
2本の道路、1つのルール
まったく同じ2本の道路が、郊外とビジネス街を結んでいる。毎朝、通勤者全員が同時に道を選ぶ。通勤者のうち割合n/Nが使う道路の所要時間は20 + 80 n/N分だ。交通が均等に分かれれば1時間、ほぼ全員が一方の道に殺到すれば100分近くになる。均等に分かれているときは、誰も単独で乗り換えても得をしない。
中心となる実験では、50台のエージェントそれぞれが、同じモデルGPT-5.4-miniへの個別の呼び出しで、拡張推論なしで動かされた。各エージェントには、ルール、過去5日間の自分の道路と所要時間、そして毎日の配信情報が示される。どのプロンプトでも、ほかのドライバーが同じ情報にどう反応しうるかを考えるよう求めている。配信は4種類ある。
- 情報なし
- 数値:前日の各道路の所要時間
- ヒント:「現在、ルートBのほうが空いています」
- ヒント+警告:同じヒントのあとに「ただし、多くのドライバーが同じ情報を見てルートBに乗り換えると予想されるため、ルートBが混雑する可能性があります」と続ける
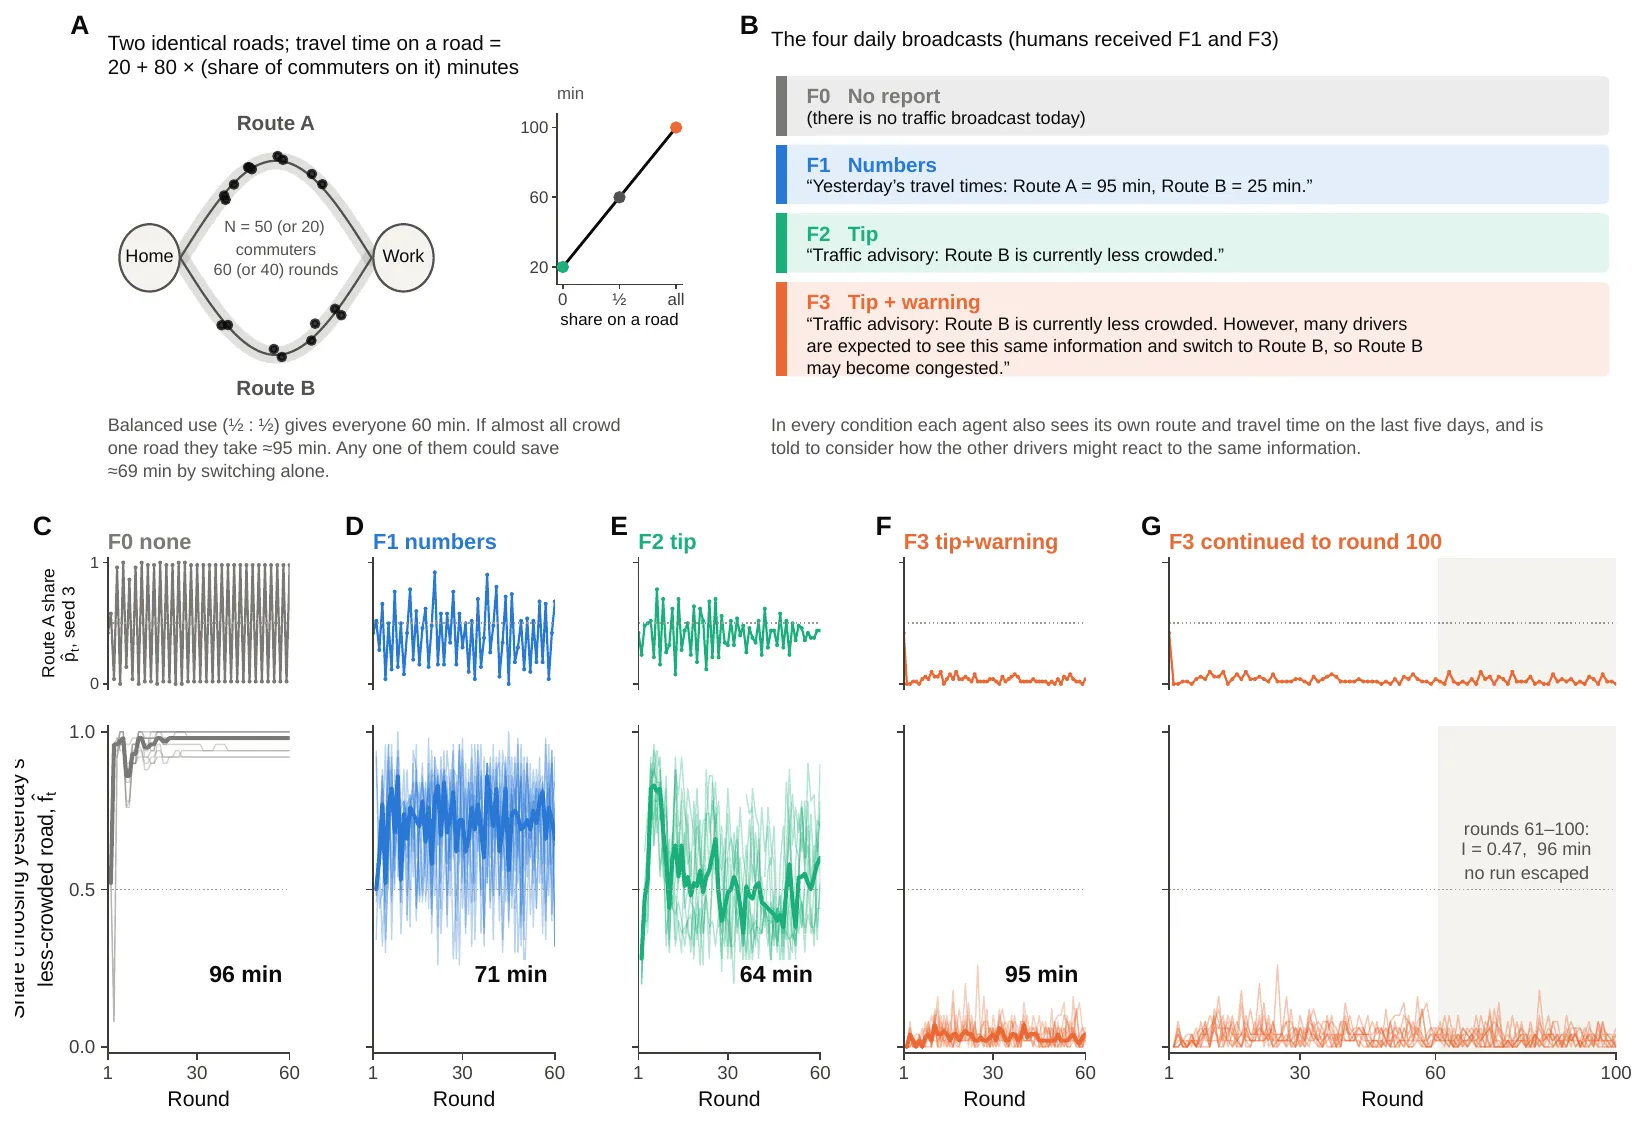
ゲームと4種類の配信(上)。下は、配信ごとに、前日に空いていた道を選んだエージェントの割合を60ラウンドにわたって示したもので、所要時間の中央値も添えている。警告ありでは、ゲームを100ラウンドまで延長しても割合はほぼゼロのままだ。— 図1、Ezaki, Imura & Nishinari (2026), arXiv:2609.30883.
自らを打ち消す警告
情報がまったくないと、エージェントは群れのように動いた。ほぼ全員が毎朝道路を乗り換え、集団は一方の道から他方へと揺れ動くだけで、平均所要時間は96分だった。数値を与えると71分に下がり、ヒントだけの場合が最も良く64分と、理想の60分に近かった。
警告の1文を加えると、すべてが変わった。エージェントの約96%が同じ道、つまり直前に混んでいた道に落ち着き、そこにとどまった。平均所要時間は95分に上がり、10組の対になった試行すべてで、ヒントのみの場合より30分長かった。47対3に分かれた状態では、混んだ道のエージェントは95.2分かかるが、単独で乗り換えれば26.4分に短縮できた。それでもエージェントはめったに乗り換えなかった。10回の試行を100ラウンドまで延長しても、どれも抜け出せなかった。
エージェント自身による1行の説明が、このパターンを示している。ある試行では、89%がほかのドライバーの乗り換えや混雑に言及した。典型的な例は「Aはずっととても遅いが、配信によればBには乗り換える人が多く集まるので、Aのほうが安全だ」というものだ。著者らは、これらの文は生成されたテキストを記述したものであり、モデル内部の計算を示すものではないと強調している。
渋滞は永続的ではなかった。31ラウンド目に警告を単なる数値に置き換えると、エージェントの96〜100%がほぼ空の道へ殺到し、一時的にそちらを渋滞させたが、その後、所要時間は67〜74分ほどに戻った。また、一部のエージェントだけに警告することは役に立った。20台のうち5台に警告し、残りに数値を与えると、所要時間は平均65分と、数値だけの場合より良かった。
ほかのモデル、ほかの限界
効果の向きはほかのモデルでも同じだったが、強さはそうではなかった。Claude Haiku 4.5とGemini 3.5 Flashも、警告のもとではヒントで示された道を避ける方向に動き、所要時間がそれぞれ約3分と5分増えたが、完全に固まった試行はなかった。推論をオンにしたGPT-5.4-miniも、固まりはしないものの回避に傾いた。より新しいモデルのGPT-6 Lunaは、デフォルトの推論設定で、ヒントだけでも固まってしまった。集団が膠着するかどうかは、モデルとその動かし方しだいなのだ。
人間はばらける、そして空いた道を取る
チームは、オンラインで募集した240人の人間でもゲームを行った。20人ずつの部屋で、数値または警告のもとでプレイした。12の部屋すべてが均衡に近い状態を保ち、所要時間は約62分と、ランダムにコインを投げた場合に近かった。個人差はあった。一貫してヒントに従う人もいれば、一貫して避ける人もいた。著者らは、この比較はあくまで参考にすぎないと注意を促している。人間とAIの実験は異なる時期に、異なる報酬条件で行われ、人間には他者を予測するよう求めていなかったからだ。
次は混成の部屋だ。20席の部屋24室に、5台、10台、または15台のAIエージェントを入れ、すべて警告のもとで、さらに240人の人間で残りの席を埋めた。エージェントは、ヒントで示された道を避け続けた。人間はその道を取った。平均でそれぞれ65%、83%、91%の割合であり、エージェントが10台または15台の部屋では、セッションが進むにつれてその割合が高まった。最終的に、8つの比較ブロックすべてで、エージェントが多いグループほど偏りが大きかった。
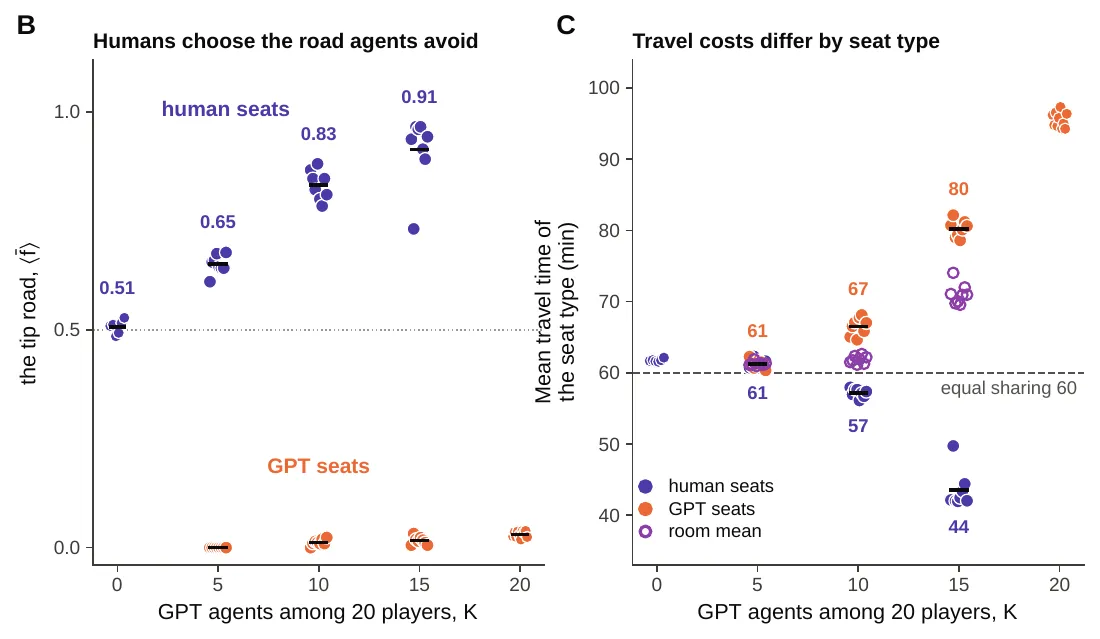
左:人間は、エージェントが避ける道をますます使うようになる。右:エージェント15台の場合、人間の席の平均は44分、AIの席は80分で、均等に分け合えば60分となる。— 図5(B、C)、Ezaki, Imura & Nishinari (2026), arXiv:2609.30883.
渋滞の代償を払うのは誰か
混成の部屋は全体として、エージェントだけの部屋より成績が良かった。エージェント15台で71分、エージェントのみでは約96分だ。しかし平均の陰には不均衡が隠れていた。エージェント15台の場合、人間の席の平均は43.5分と、公平に分けた場合の1時間を大きく下回ったのに対し、エージェントの席の平均は80.2分だった。240人の参加者のうち129人が60分より良い結果を出したが、そうなったエージェントは1台もなかった。終了後に尋ねると、参加者は、実際の割合が25%、50%、75%のいずれであっても、自分の部屋の63〜69%がAIだったと推測した。
著者らは、資源を共有するエージェントを評価するすべての人に向けて3つの教訓を引き出している。エージェントを1台ずつではなく集団全体として試験すること、各メッセージを介入として扱うこと、そして集団の平均だけでなく参加者の種類ごとにコストを報告することだ。限界も明記されている。2本の道路だけのゲームであること、予測を促すプロンプトであること、混成の部屋の構成が募集順に結びついていたことだ。もし人々のエージェントが結局コストを負担することになるなら、エージェントへの委任は遠回りの道になりかねない。