UNA SOLA FRASE ATRAPA A LOS CONDUCTORES IA EN UN ATASCO
Los agentes de IA construidos sobre un puñado de modelos compartidos actúan cada vez más en nombre de muchas personas. Takahiro Ezaki, Naoto Imura y Katsuhiro Nishinari, de la Universidad de Tokio, querían saber qué ocurre cuando muchos de esos agentes reciben el mismo mensaje, sobre todo una previsión de lo que harán todos los demás. Una vez difundida, esa previsión cambia la situación que describe y puede desmentir su propia predicción.
Para comprobarlo, eligieron uno de los escenarios más sencillos en los que las personas compiten por un recurso limitado: el trayecto al trabajo.
Dos carreteras, una regla
Dos carreteras idénticas unen un barrio periférico con un distrito de negocios. Cada mañana, todos los conductores eligen a la vez. Una carretera utilizada por una fracción n/N de ellos tarda 20 + 80 n/N minutos: una hora si el tráfico se reparte a partes iguales, cerca de 100 minutos si casi todos se amontonan en una sola carretera. Con un reparto equilibrado, nadie puede ganar cambiando por su cuenta.
En el experimento principal, cada uno de los 50 agentes es una llamada independiente al mismo modelo, GPT-5.4-mini, ejecutado sin razonamiento extendido. Cada agente ve las reglas, su propia carretera y los tiempos de trayecto de los cinco últimos días, además de un boletín diario. Cada instrucción (prompt) también pide al agente que piense en cómo podrían reaccionar los demás conductores ante la misma información. El boletín tiene cuatro versiones:
- ningún informe;
- cifras: el tiempo de trayecto de ayer en cada carretera;
- un consejo: «La ruta B está actualmente menos congestionada»;
- un consejo más un aviso: el mismo consejo, seguido de «Sin embargo, se espera que muchos conductores vean esta misma información y cambien a la ruta B, por lo que la ruta B podría congestionarse».
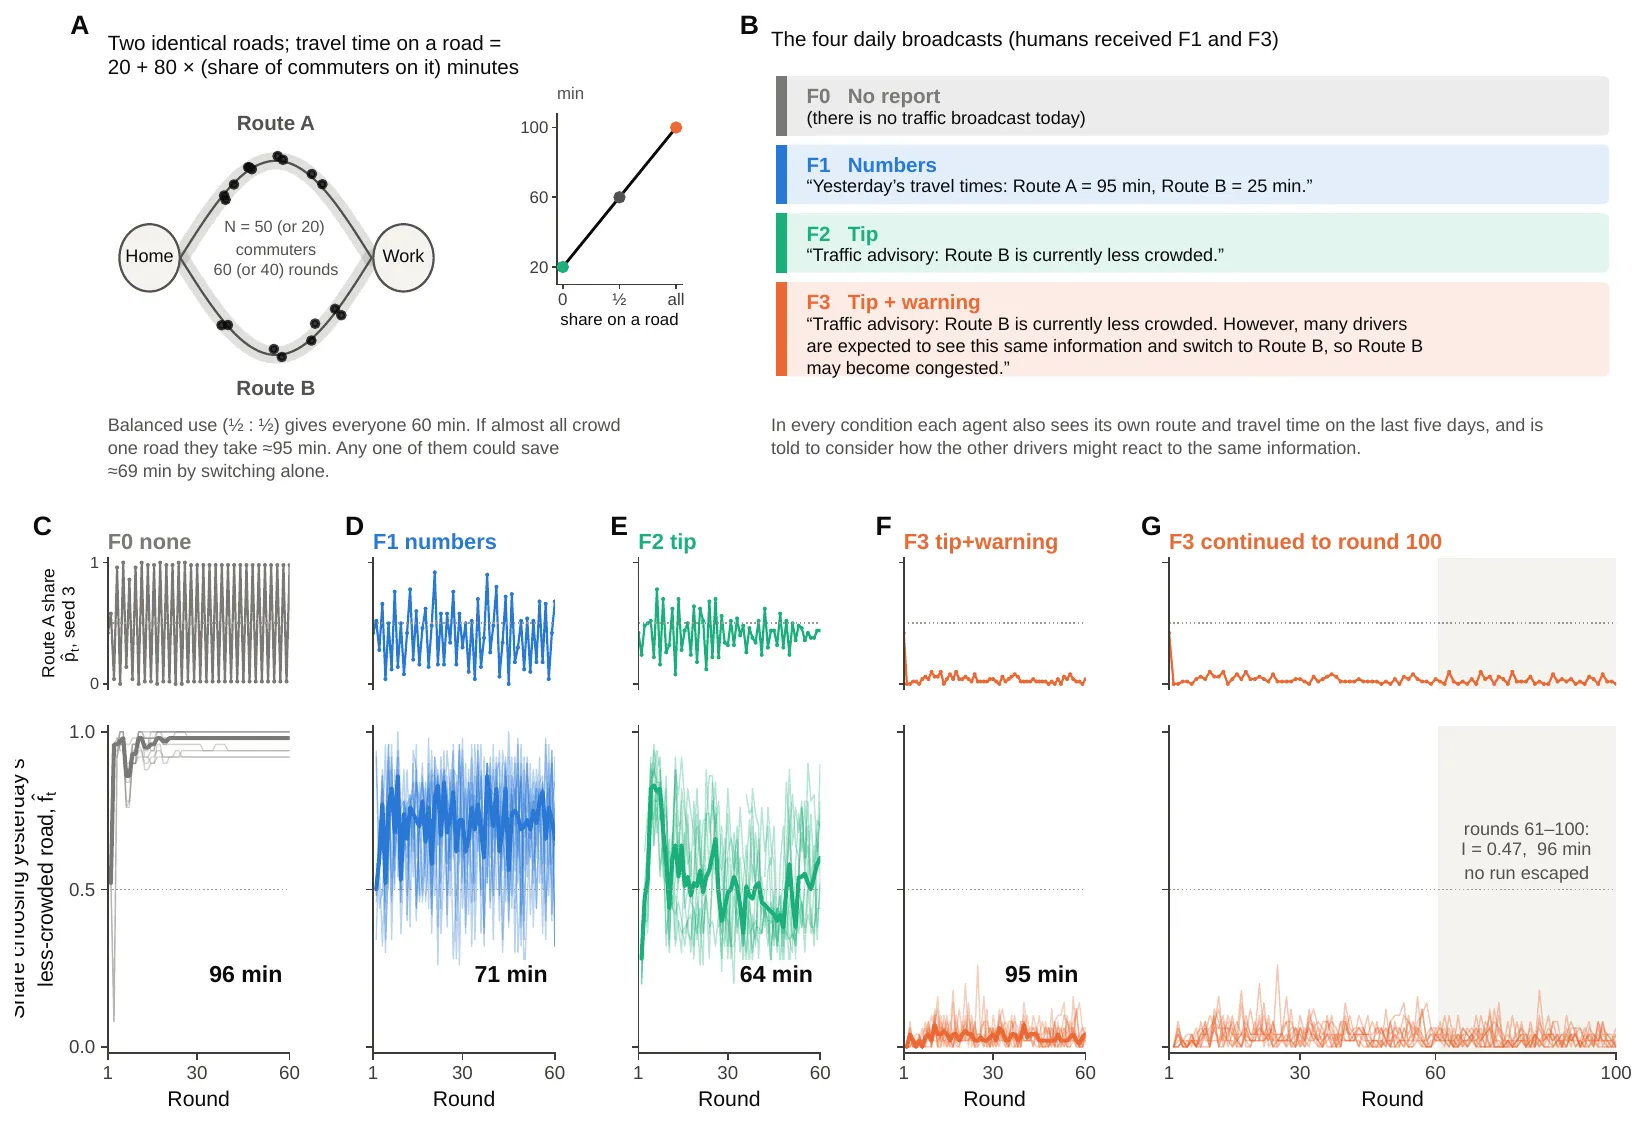
El juego y los cuatro boletines (arriba); abajo, para cada boletín, la proporción de agentes que eligen la carretera menos congestionada del día anterior durante 60 rondas, con el tiempo medio (mediana) de trayecto. Con el aviso, la proporción se mantiene cerca de cero, incluso cuando el juego se prolonga hasta la ronda 100. — Figura 1, Ezaki, Imura & Nishinari (2026), arXiv:2609.30883.
Un aviso que se derrota a sí mismo
Sin ningún informe, los agentes se movían en manada: casi todos cambiaban de carretera cada mañana, y la multitud simplemente oscilaba de una carretera a otra, con una media de 96 minutos. Las cifras la redujeron a 71 minutos; el consejo a secas fue lo mejor, con 64 minutos, cerca de los 60 minutos ideales.
Añadir la frase de aviso lo cambió todo. Alrededor del 96 % de los agentes se instaló en la misma carretera —la que acababa de estar abarrotada— y se quedó allí. El tiempo medio de trayecto subió a 95 minutos, 30 minutos más que con el consejo solo, en las diez ejecuciones emparejadas. Con un reparto de 47 a 3, un agente en la carretera atascada necesita 95,2 minutos; cambiar él solo habría reducido ese tiempo a 26,4 minutos. Los agentes rara vez lo hicieron. Cuando las diez ejecuciones se prolongaron hasta 100 rondas, ninguna escapó.
Las propias explicaciones de una línea de los agentes revelan el patrón. En una ejecución, el 89 % de ellos mencionaba que otros conductores cambiaban o que había aglomeración. Una típica: «A ha sido siempre muy lenta para mí, pero el boletín advierte de que B atraerá a muchos conductores que cambien, así que A es la apuesta más segura». Los autores subrayan que estas frases describen texto generado, no el cálculo interno del modelo.
El atasco no era permanente. Sustituir el aviso por cifras simples en la ronda 31 hizo que entre el 96 y el 100 % de los agentes se lanzara a la carretera casi vacía —atascándola brevemente a su vez— antes de que los costes volvieran a unos 67-74 minutos. Y avisar solo a algunos agentes ayudó: con 5 de 20 agentes avisados y el resto con cifras, los trayectos promediaron 65 minutos, mejor que solo con cifras.
Otros modelos, otros límites
La dirección del efecto se mantuvo, pero no toda su intensidad. Claude Haiku 4.5 y Gemini 3.5 Flash también tendieron a evitar la carretera recomendada bajo el aviso, añadiendo unos 3 y 5 minutos, pero ninguna de sus ejecuciones se congeló por completo. GPT-5.4-mini con el razonamiento activado seguía inclinándose a evitarla, sin congelarse. Un modelo más reciente, GPT-6 Luna, con su nivel de razonamiento por defecto, se congeló incluso con el consejo a secas. Que una población se bloquee depende del modelo y de cómo se ejecute.
Las personas se reparten, y toman la carretera libre
El equipo también jugó con 240 personas reclutadas en línea, en salas de 20, con las cifras o con el aviso. Las doce salas se mantuvieron cerca del equilibrio, en torno a 62 minutos, cerca de lo que daría lanzar una moneda al aire. Los individuos eran distintos: unos seguían siempre el consejo, otros lo evitaban siempre. Los autores advierten de que esta comparación es solo orientativa: los estudios con personas y con IA se hicieron en momentos distintos, con incentivos distintos, y a las personas no se les pidió que anticiparan lo que harían los demás.
Luego llegaron las salas mixtas: 24 salas de 20 plazas, con 5, 10 o 15 agentes de IA, todas bajo el aviso, completadas por otras 240 personas. Los agentes siguieron evitando la carretera recomendada. Las personas la tomaron: de media el 65 %, el 83 % y el 91 % de las veces —y, en las salas con 10 o 15 agentes, cada vez más a medida que avanzaba la sesión—. Al final, los grupos con más agentes estaban más desequilibrados, en cada uno de los ocho bloques de comparación.
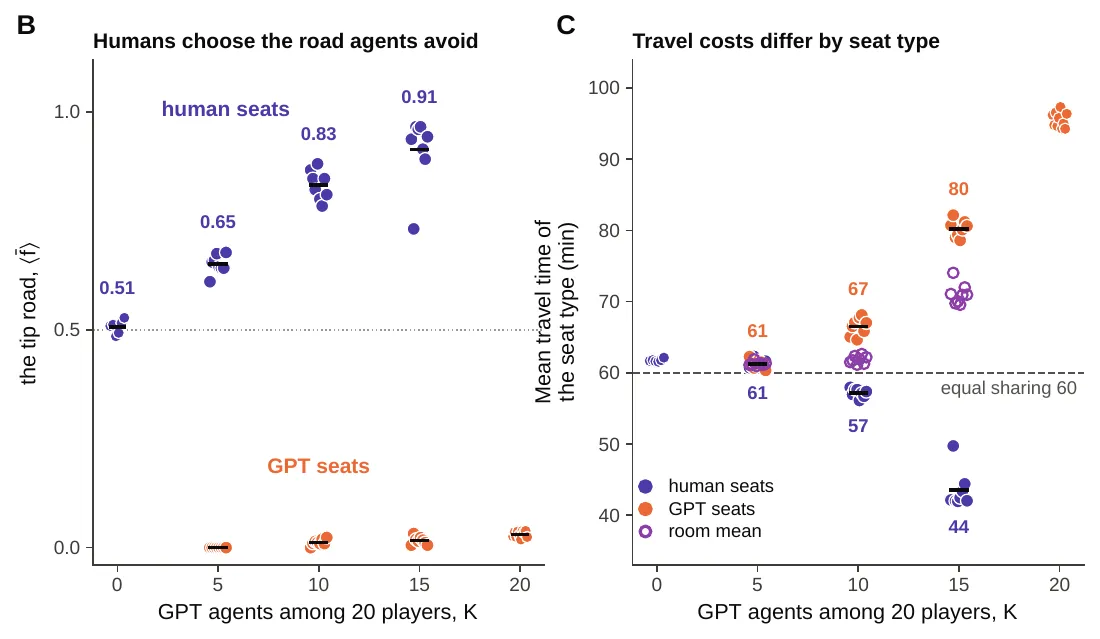
Izquierda: las personas toman cada vez más la carretera que los agentes evitan. Derecha: con 15 agentes, las plazas humanas promedian 44 minutos y las de IA 80, frente a 60 con un reparto equitativo. — Figura 5 (B, C), Ezaki, Imura & Nishinari (2026), arXiv:2609.30883.
Quién paga el atasco
Las salas mixtas funcionaron mejor en conjunto que las salas solo de agentes: 71 minutos con 15 agentes, frente a unos 96. Pero la media ocultaba un desequilibrio. Con 15 agentes, las plazas humanas promediaron 43,5 minutos, muy por debajo de la hora de un reparto justo, mientras que las de los agentes promediaron 80,2. De los 240 participantes, 129 bajaron de 60 minutos; ningún agente lo logró. Preguntados después, los participantes estimaron que entre el 63 y el 69 % de su sala era IA, tanto si la proporción real era del 25 %, del 50 % o del 75 %.
Los autores extraen tres lecciones para quien evalúe agentes que comparten un recurso: probar poblaciones enteras, no un agente cada vez; tratar cada mensaje como una intervención; y presentar los costes por tipo de participante, no solo la media del grupo. También son explícitos sobre sus límites: un juego de dos carreteras, instrucciones que invitan a anticipar y salas mixtas cuya composición dependía del orden de reclutamiento. Si los agentes de las personas acaban cargando con los costes, delegar en ellos podría resultar ser el camino lento.