SATU KALIMAT MENJEBAK PENGEMUDI AI DALAM KEMACETAN
Agen AI yang dibangun di atas segelintir model yang sama semakin sering bertindak atas nama banyak orang. Takahiro Ezaki, Naoto Imura, dan Katsuhiro Nishinari dari University of Tokyo ingin tahu apa yang terjadi ketika banyak agen semacam itu menerima pesan yang sama — terutama ramalan tentang apa yang akan dilakukan semua orang lain. Begitu disiarkan, ramalan seperti itu mengubah situasi yang digambarkannya, dan dapat menggagalkan prediksinya sendiri.
Untuk mengujinya, mereka memilih salah satu situasi paling sederhana di mana orang bersaing memperebutkan sumber daya terbatas: perjalanan ke tempat kerja.
Dua jalan, satu aturan
Dua jalan identik menghubungkan sebuah daerah pinggiran dengan kawasan bisnis. Setiap pagi, semua komuter memilih pada saat yang sama. Jalan yang dipakai oleh porsi n/N dari mereka memakan waktu 20 + 80 n/N menit: satu jam jika lalu lintas terbagi rata, hampir 100 menit jika hampir semua orang menumpuk di satu jalan. Pada pembagian rata, tidak ada yang bisa untung dengan berpindah sendirian.
Dalam eksperimen inti, masing-masing dari 50 agen adalah panggilan terpisah ke model yang sama, GPT-5.4-mini, dijalankan tanpa penalaran diperluas. Setiap agen melihat aturan, jalannya sendiri dan waktu tempuh selama lima hari terakhir, serta siaran harian. Setiap prompt juga meminta agen untuk memikirkan bagaimana pengemudi lain mungkin bereaksi terhadap informasi yang sama. Siaran itu hadir dalam empat versi:
- tanpa laporan sama sekali;
- angka: waktu tempuh kemarin di setiap jalan;
- kiat: “Rute B saat ini lebih sepi”;
- kiat plus peringatan: kiat yang sama, diikuti “Namun, banyak pengemudi diperkirakan melihat informasi yang sama ini dan berpindah ke Rute B, sehingga Rute B bisa menjadi macet.”
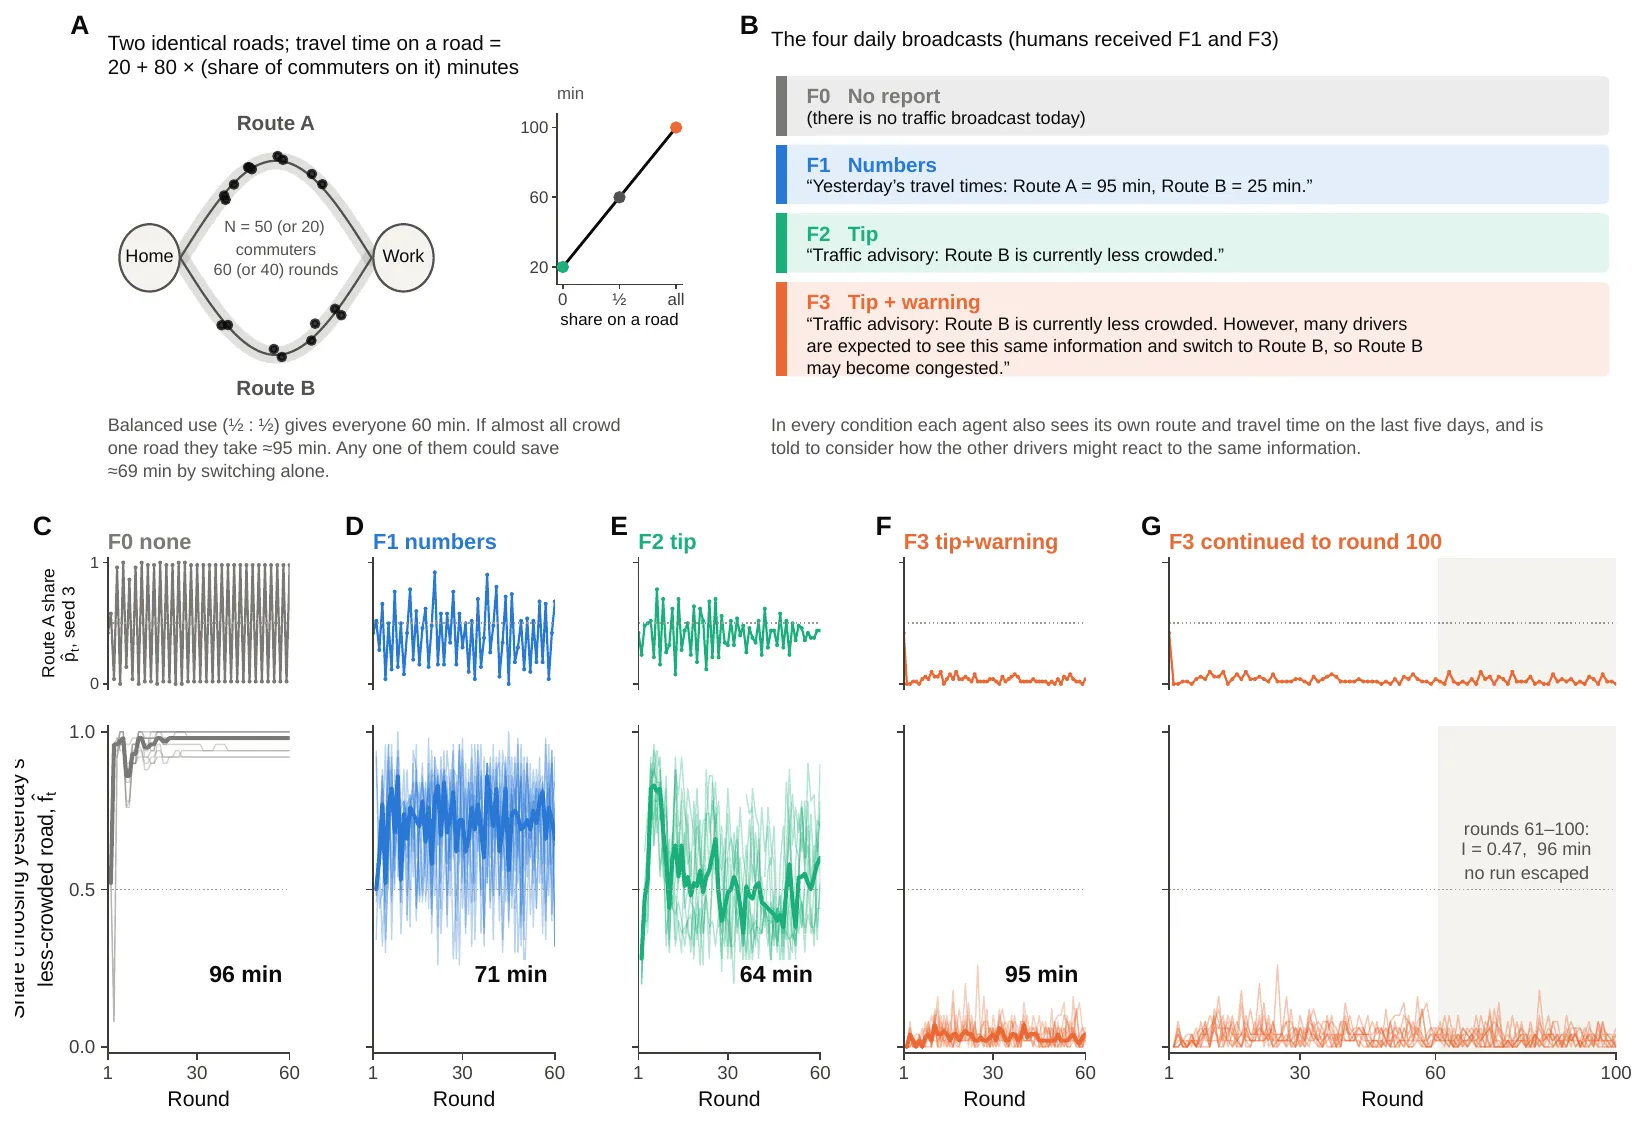
Permainan dan empat siaran (atas); di bawah, untuk setiap siaran, porsi agen yang memilih jalan yang kemarin lebih sepi selama 60 putaran, beserta median waktu tempuh. Dengan peringatan, porsinya tetap mendekati nol, bahkan ketika permainan dilanjutkan hingga putaran ke-100. — Gambar 1, Ezaki, Imura & Nishinari (2026), arXiv:2609.30883.
Peringatan yang menggagalkan dirinya sendiri
Tanpa laporan apa pun, para agen bergerak bergerombol: hampir semuanya berganti jalan setiap pagi, dan kerumunan itu hanya berayun dari satu jalan ke jalan lain, dengan rata-rata 96 menit. Angka menurunkannya menjadi 71 menit; kiat saja memberi hasil terbaik, yaitu 64 menit, mendekati ideal 60 menit.
Menambahkan kalimat peringatan mengubah segalanya. Sekitar 96% agen menetap di jalan yang sama — jalan yang baru saja padat — dan bertahan di sana. Waktu tempuh rata-rata naik menjadi 95 menit, 30 menit lebih lama daripada dengan kiat saja, di kesepuluh pasangan percobaan. Pada pembagian 47 lawan 3, agen di jalan yang macet membutuhkan 95,2 menit; berpindah sendirian akan memangkasnya menjadi 26,4 menit. Para agen jarang melakukannya. Ketika sepuluh percobaan diperpanjang hingga 100 putaran, tidak ada yang lolos.
Penjelasan satu baris dari para agen sendiri menunjukkan polanya. Dalam satu percobaan, 89% dari mereka menyebut pengemudi lain yang berpindah atau berkerumun. Contoh khasnya: “A selalu sangat lambat bagi saya, tetapi siaran memperingatkan bahwa B akan menarik banyak pengemudi yang berpindah, jadi A adalah pilihan yang lebih aman.” Para penulis menekankan bahwa kalimat-kalimat ini menggambarkan teks yang dihasilkan, bukan komputasi internal model.
Kemacetan itu tidak permanen. Mengganti peringatan dengan angka biasa pada putaran ke-31 membuat 96–100% agen bergegas ke jalan yang hampir kosong — sempat membuatnya macet — sebelum biaya turun kembali ke sekitar 67–74 menit. Dan memperingatkan hanya sebagian agen justru membantu: dengan 5 dari 20 agen diperingatkan dan sisanya diberi angka, perjalanan rata-rata 65 menit, lebih baik daripada angka saja.
Model lain, batas lain
Arah efeknya terbawa, tetapi tidak dengan kekuatan penuhnya. Claude Haiku 4.5 dan Gemini 3.5 Flash juga cenderung menghindari jalan yang disarankan di bawah peringatan, menambah sekitar 3 dan 5 menit, tetapi tidak satu pun percobaan mereka membeku sepenuhnya. GPT-5.4-mini dengan penalaran diaktifkan masih condong menghindar tanpa membeku. Model yang lebih baru, GPT-6 Luna, pada pengaturan penalaran bawaannya, membeku bahkan dengan kiat saja. Apakah sebuah populasi terkunci bergantung pada model dan cara menjalankannya.
Manusia menyebar — dan mengambil jalan yang lengang
Tim juga menjalankan permainan ini dengan 240 orang yang direkrut secara daring, dalam ruang berisi 20 orang, dengan angka atau dengan peringatan. Kedua belas ruang tetap mendekati keseimbangan, sekitar 62 menit, mendekati hasil lemparan koin acak. Individu berbeda-beda: sebagian konsisten mengikuti kiat, sebagian lain konsisten menghindarinya. Para penulis mengingatkan bahwa perbandingan ini hanya bersifat kontekstual: studi manusia dan AI dijalankan pada waktu berbeda, dengan insentif berbeda, dan manusia tidak diminta untuk mengantisipasi orang lain.
Lalu datanglah ruang campuran: 24 ruang berisi 20 kursi, dengan 5, 10, atau 15 agen AI, semuanya di bawah peringatan, diisi oleh 240 orang lagi. Para agen terus menghindari jalan yang disarankan. Manusia mengambilnya: rata-rata 65%, 83%, dan 91% dari waktu — dan, di ruang dengan 10 atau 15 agen, makin sering seiring berjalannya sesi. Pada akhirnya, kelompok dengan lebih banyak agen lebih tidak seimbang, di kedelapan blok perbandingan.
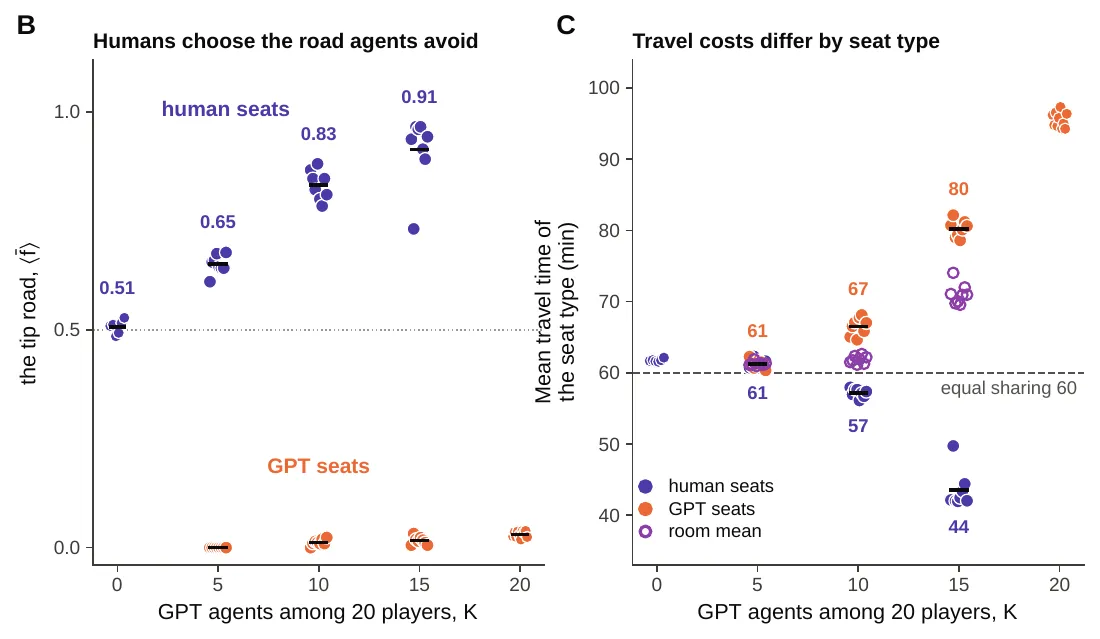
Kiri: manusia makin sering mengambil jalan yang dihindari para agen. Kanan: dengan 15 agen, kursi manusia rata-rata 44 menit dan kursi AI 80, dibandingkan 60 untuk pembagian rata. — Gambar 5 (B, C), Ezaki, Imura & Nishinari (2026), arXiv:2609.30883.
Siapa yang menanggung kemacetan
Secara keseluruhan, ruang campuran lebih baik daripada ruang yang hanya berisi agen — 71 menit dengan 15 agen, dibandingkan sekitar 96. Namun rata-rata itu menyembunyikan ketimpangan. Dengan 15 agen, kursi manusia rata-rata 43,5 menit, jauh di bawah satu jam pembagian yang adil, sementara kursi agen rata-rata 80,2. Dari 240 peserta, 129 mencatat waktu lebih baik dari 60 menit; tidak ada satu agen pun yang berhasil. Ketika ditanya sesudahnya, peserta menebak bahwa 63–69% isi ruang mereka adalah AI, terlepas dari apakah porsi sebenarnya 25%, 50%, atau 75%.
Para penulis menarik tiga pelajaran bagi siapa pun yang mengevaluasi agen yang berbagi sumber daya: uji seluruh populasi, bukan satu agen pada satu waktu; perlakukan setiap pesan sebagai intervensi; dan laporkan biaya menurut jenis peserta, bukan hanya rata-rata kelompok. Keterbatasan mereka juga dinyatakan dengan jelas: permainan dua jalan, prompt yang mendorong antisipasi, dan ruang campuran yang komposisinya terkait dengan urutan perekrutan. Jika agen milik orang-orang akhirnya menanggung biayanya, mendelegasikan tugas kepada mereka bisa ternyata menjadi jalan yang lambat.