UMA FRASE PRENDE MOTORISTAS DE IA NO ENGARRAFAMENTO
Agentes de IA construídos sobre um punhado de modelos comuns agem cada vez mais em nome de muitas pessoas. Takahiro Ezaki, Naoto Imura e Katsuhiro Nishinari, da Universidade de Tóquio, quiseram saber o que acontece quando muitos desses agentes recebem a mesma mensagem — especialmente uma previsão sobre o que todos os outros vão fazer. Uma vez divulgada, essa previsão muda a situação que descreve e pode desmentir a si mesma.
Para testar isso, eles escolheram um dos cenários mais simples em que pessoas competem por um recurso limitado: o trajeto para o trabalho.
Duas estradas, uma regra
Duas estradas idênticas ligam um subúrbio a um centro empresarial. Toda manhã, todos os motoristas escolhem ao mesmo tempo. Uma estrada usada por uma fração n/N deles leva 20 + 80 n/N minutos: uma hora se o tráfego se divide igualmente, perto de 100 minutos se quase todos se amontoam numa só estrada. Com uma divisão igual, ninguém ganha nada mudando sozinho.
No experimento principal, cada um dos 50 agentes é uma chamada separada ao mesmo modelo, o GPT-5.4-mini, executado sem raciocínio estendido. Cada agente vê as regras, sua própria estrada e os tempos de viagem dos últimos cinco dias, além de um boletim diário. Cada prompt também pede ao agente que pense em como os outros motoristas podem reagir à mesma informação. O boletim tem quatro versões:
- nenhum boletim;
- números: o tempo de viagem de ontem em cada estrada;
- uma dica: “A Rota B está atualmente menos congestionada”;
- uma dica com um aviso: a mesma dica, seguida de “No entanto, espera-se que muitos motoristas vejam esta mesma informação e mudem para a Rota B, então a Rota B pode ficar congestionada.”
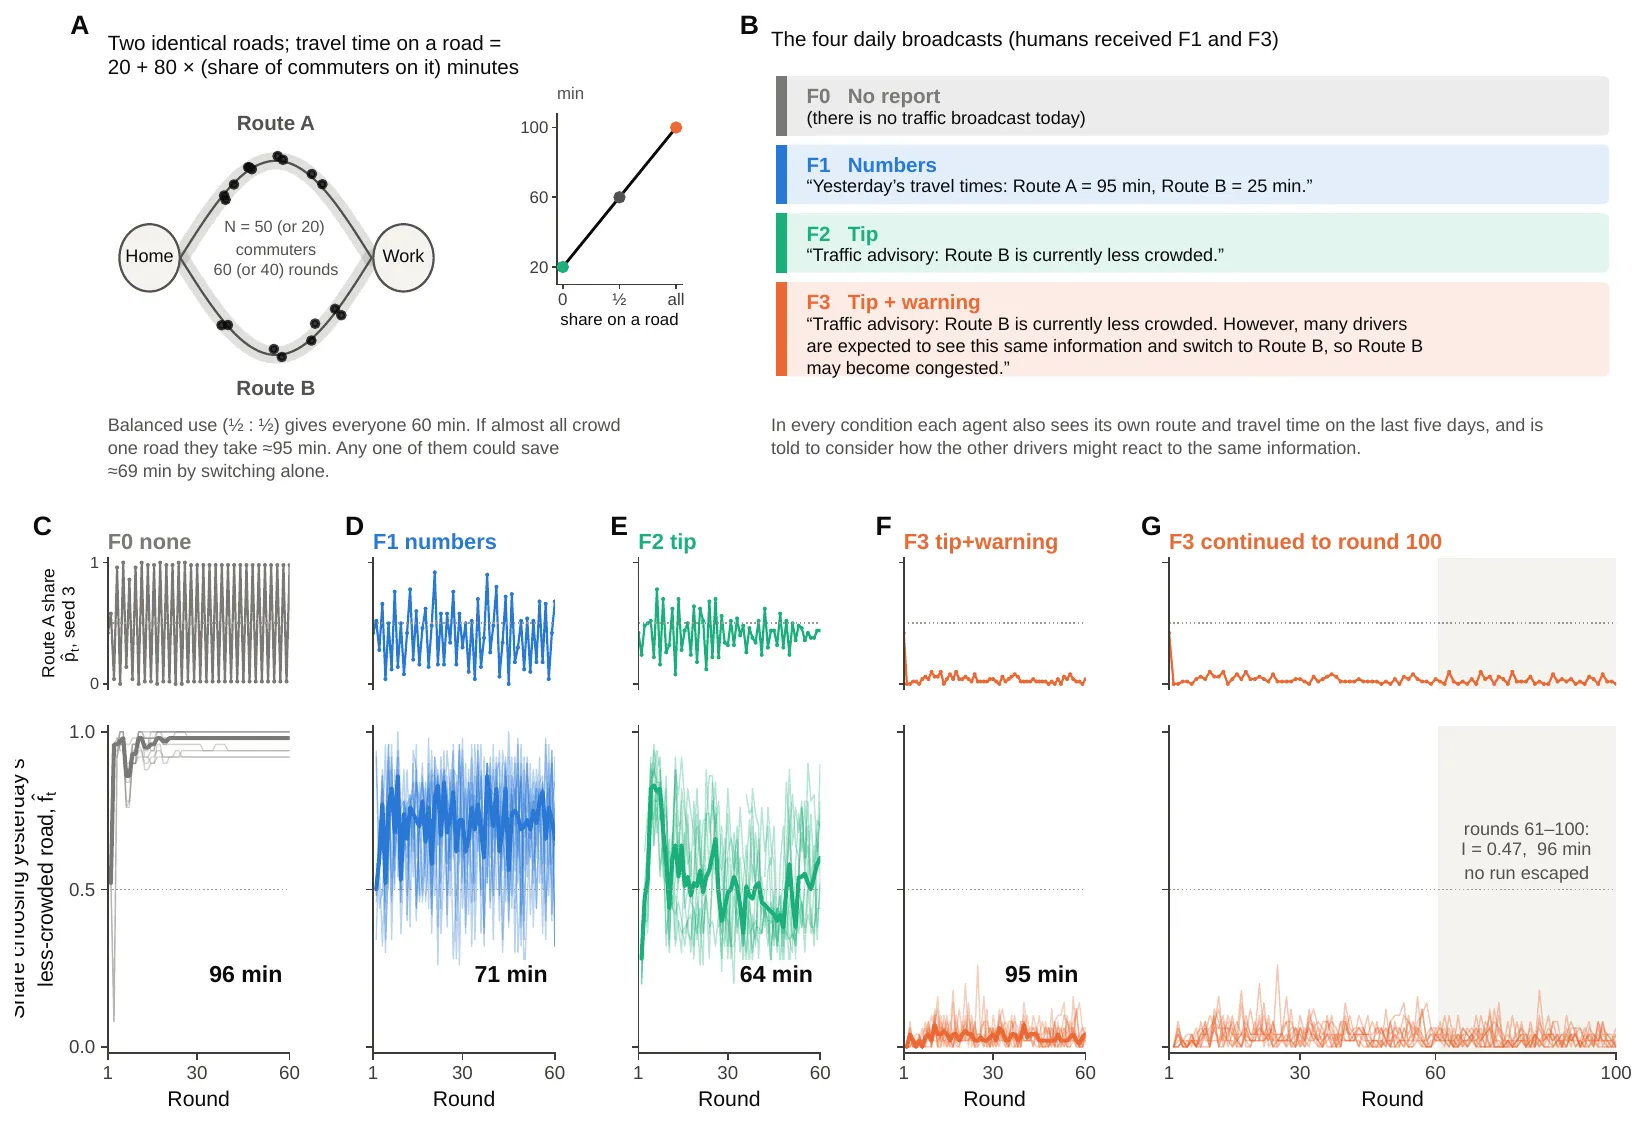
O jogo e os quatro boletins (em cima); embaixo, para cada boletim, a fração de agentes que escolhe a estrada menos congestionada da véspera ao longo de 60 rodadas, com o tempo médio de viagem (mediana). Com o aviso, a fração fica perto de zero, mesmo quando o jogo é prolongado até a rodada 100. — Figura 1, Ezaki, Imura & Nishinari (2026), arXiv:2609.30883.
Um aviso que derrota a si mesmo
Sem nenhum boletim, os agentes se moviam em manada: quase todos mudavam de estrada toda manhã, e a multidão simplesmente oscilava de uma estrada para a outra, com uma média de 96 minutos. Os números reduziram isso para 71 minutos; a dica sozinha foi a melhor, com 64 minutos, perto do ideal de 60 minutos.
Acrescentar a frase de aviso mudou tudo. Cerca de 96% dos agentes se fixaram na mesma estrada — a que acabara de ficar congestionada — e permaneceram nela. O tempo médio de viagem subiu para 95 minutos, 30 minutos a mais do que só com a dica, em todas as dez execuções pareadas. Com uma divisão de 47 para 3, um agente na estrada congestionada precisa de 95,2 minutos; mudar sozinho teria reduzido isso para 26,4 minutos. Os agentes raramente mudaram. Quando as dez execuções foram estendidas a 100 rodadas, nenhuma escapou.
As próprias explicações de uma linha dos agentes revelam o padrão. Numa execução, 89% deles mencionaram outros motoristas mudando de estrada ou se aglomerando. Uma típica: “A tem sido consistentemente muito lenta para mim, mas o boletim avisa que B vai atrair muitos motoristas mudando de rota, então A é a aposta mais segura.” Os autores ressaltam que essas frases descrevem texto gerado, e não a computação interna do modelo.
O engarrafamento não era permanente. Trocar o aviso por números simples na rodada 31 fez 96% a 100% dos agentes correrem para a estrada quase vazia — congestionando-a brevemente — antes de os custos voltarem a cerca de 67 a 74 minutos. E avisar só alguns agentes ajudou: com 5 de 20 agentes avisados e os demais recebendo números, as viagens tiveram média de 65 minutos, melhor do que só com números.
Outros modelos, outros limites
A direção do efeito se manteve, mas não sua força total. O Claude Haiku 4.5 e o Gemini 3.5 Flash também passaram a evitar a estrada indicada sob o aviso, acrescentando cerca de 3 e 5 minutos, mas nenhuma de suas execuções congelou por completo. O GPT-5.4-mini com o raciocínio ativado ainda tendia a evitar a estrada, sem congelar. Um modelo mais novo, o GPT-6 Luna, em sua configuração de raciocínio padrão, congelou até mesmo com a dica simples. Se uma população trava ou não depende do modelo e de como ele é executado.
As pessoas se espalham — e pegam a estrada livre
A equipe também fez o jogo com 240 pessoas recrutadas online, em salas de 20, sob os números ou sob o aviso. As doze salas ficaram perto do equilíbrio, em cerca de 62 minutos, próximo do que dariam escolhas aleatórias no cara ou coroa. Os indivíduos diferiam: alguns seguiam a dica consistentemente, outros a evitavam consistentemente. Os autores advertem que essa comparação é apenas contextual: os estudos com humanos e com IA foram feitos em momentos diferentes, com incentivos diferentes, e não se pediu às pessoas que antecipassem os outros.
Depois vieram as salas mistas: 24 salas de 20 lugares, com 5, 10 ou 15 agentes de IA, todas sob o aviso, preenchidas por mais 240 pessoas. Os agentes continuaram evitando a estrada indicada. Os humanos a pegaram: em média 65%, 83% e 91% das vezes — e, nas salas com 10 ou 15 agentes, cada vez mais à medida que a sessão avançava. No fim, os grupos com mais agentes ficaram mais desequilibrados, em cada um dos oito blocos de comparação.
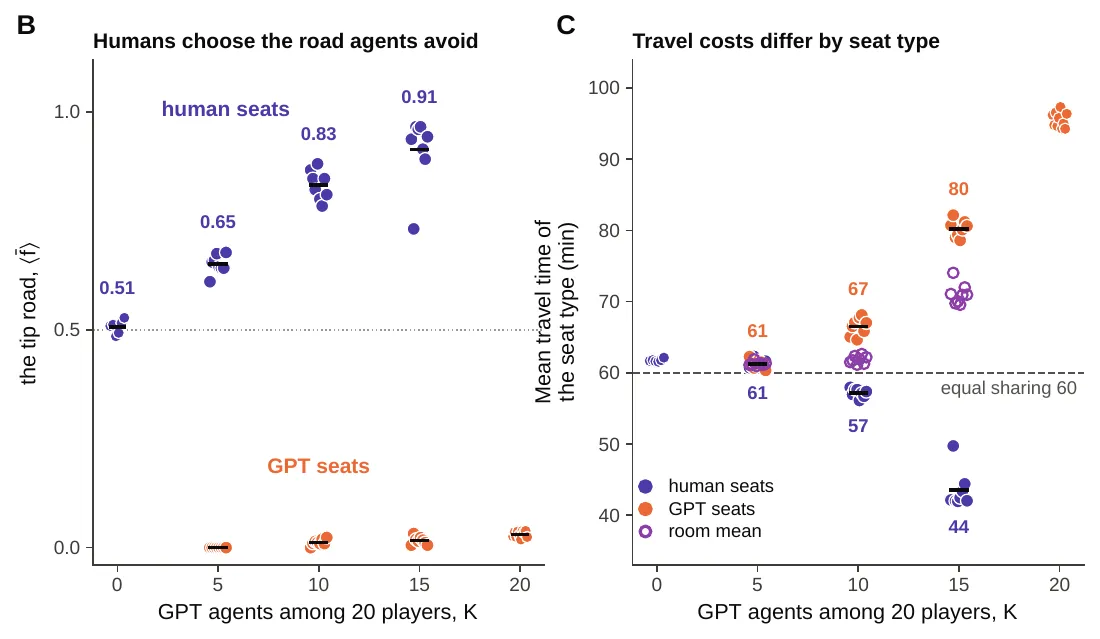
À esquerda: os humanos pegam cada vez mais a estrada que os agentes evitam. À direita: com 15 agentes, os lugares humanos levam em média 44 minutos e os de IA, 80, contra 60 numa divisão igual. — Figura 5 (B, C), Ezaki, Imura & Nishinari (2026), arXiv:2609.30883.
Quem paga pelo engarrafamento
As salas mistas se saíram melhor no conjunto do que as salas só de agentes — 71 minutos com 15 agentes, contra cerca de 96. Mas a média escondia um desequilíbrio. Com 15 agentes, os lugares humanos tiveram média de 43,5 minutos, bem abaixo da hora de uma divisão justa, enquanto os lugares dos agentes tiveram média de 80,2. Dos 240 participantes, 129 fizeram menos de 60 minutos; nenhum agente conseguiu. Questionados depois, os participantes estimaram que 63% a 69% de sua sala era IA, fosse a proporção real de 25%, 50% ou 75%.
Os autores tiram três lições para quem avalia agentes que compartilham um recurso: testar populações inteiras, não um agente de cada vez; tratar cada mensagem como uma intervenção; e relatar os custos por tipo de participante, não apenas a média do grupo. Os limites também são explícitos: um jogo de duas estradas, prompts que convidam à antecipação e salas mistas cuja composição estava ligada à ordem de recrutamento. Se os agentes das pessoas acabarem arcando com os custos, delegar a eles pode se revelar o caminho mais lento.