EIN SATZ SCHICKT KI-FAHRER IN DEN STAU
KI-Agenten, die auf einer Handvoll gemeinsamer Modelle beruhen, handeln zunehmend im Namen vieler Menschen. Takahiro Ezaki, Naoto Imura und Katsuhiro Nishinari von der Universität Tokio wollten wissen, was geschieht, wenn viele dieser Agenten dieselbe Nachricht erhalten — insbesondere eine Prognose darüber, was alle anderen tun werden. Einmal verbreitet, verändert eine solche Prognose genau die Lage, die sie beschreibt, und kann sich selbst widerlegen.
Um das zu testen, wählten sie eine der einfachsten Situationen, in denen Menschen um eine begrenzte Ressource konkurrieren: den Weg zur Arbeit.
Zwei Straßen, eine Regel
Zwei identische Straßen verbinden einen Vorort mit einem Geschäftsviertel. Jeden Morgen entscheiden sich alle Pendler gleichzeitig. Eine Straße, die von einem Anteil n/N von ihnen genutzt wird, braucht 20 + 80 n/N Minuten: eine Stunde, wenn sich der Verkehr gleichmäßig aufteilt, fast 100 Minuten, wenn sich nahezu alle auf eine Straße drängen. Bei gleichmäßiger Aufteilung kann niemand gewinnen, indem er allein wechselt.
Im Kernexperiment ist jeder der 50 Agenten ein separater Aufruf desselben Modells, GPT-5.4-mini, ohne erweitertes Schlussfolgern ausgeführt. Jeder Agent sieht die Regeln, seine eigene Straße und die Fahrzeiten der letzten fünf Tage sowie eine tägliche Meldung. Jeder Prompt fordert den Agenten außerdem auf, darüber nachzudenken, wie die anderen Fahrer auf dieselbe Information reagieren könnten. Die Meldung gibt es in vier Versionen:
- gar keine Meldung;
- Zahlen: die gestrige Fahrzeit auf jeder Straße;
- ein Tipp: „Route B ist derzeit weniger voll“;
- ein Tipp plus eine Warnung: derselbe Tipp, gefolgt von „Allerdings werden voraussichtlich viele Fahrer dieselbe Information sehen und auf Route B wechseln, sodass Route B verstopfen könnte.“
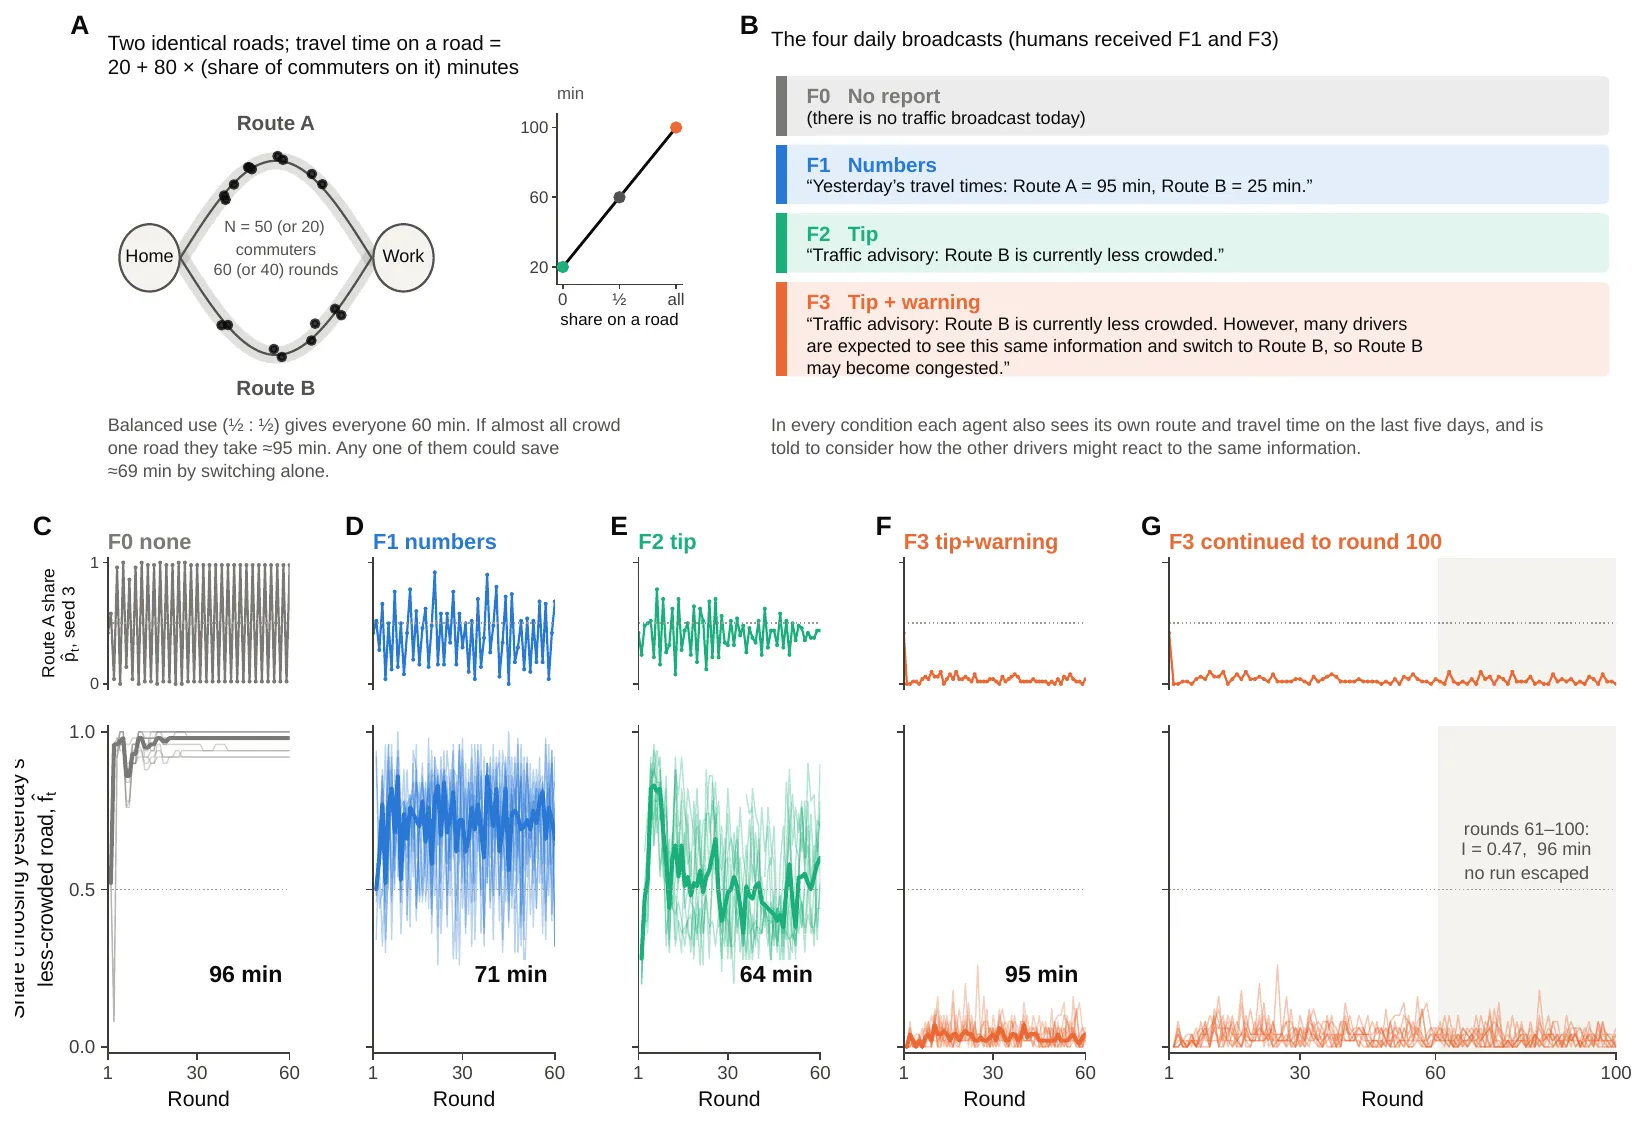
Das Spiel und die vier Meldungen (oben); darunter für jede Meldung der Anteil der Agenten, die über 60 Runden die gestern weniger volle Straße wählen, mit der medianen Fahrzeit. Unter der Warnung bleibt der Anteil nahe null, selbst wenn das Spiel bis Runde 100 fortgesetzt wird. — Abbildung 1, Ezaki, Imura & Nishinari (2026), arXiv:2609.30883.
Eine Warnung, die sich selbst vereitelt
Ohne Meldung bewegten sich die Agenten als Herde: Fast alle wechselten jeden Morgen die Straße, und die Masse schwang einfach von einer Straße zur anderen, im Schnitt mit 96 Minuten. Zahlen senkten das auf 71 Minuten; der bloße Tipp schnitt am besten ab, mit 64 Minuten, nah am Ideal von 60 Minuten.
Der Warnsatz änderte alles. Etwa 96 % der Agenten ließen sich auf derselben Straße nieder — der, die gerade voll gewesen war — und blieben dort. Die mittlere Fahrzeit stieg auf 95 Minuten, 30 Minuten mehr als mit dem Tipp allein, in allen zehn gepaarten Durchläufen. Bei einer Aufteilung von 47 zu 3 braucht ein Agent auf der verstopften Straße 95,2 Minuten; ein Wechsel im Alleingang hätte das auf 26,4 Minuten verkürzt. Die Agenten taten es selten. Als die zehn Durchläufe auf 100 Runden verlängert wurden, entkam keiner.
Die eigenen einzeiligen Begründungen der Agenten zeigen das Muster. In einem Durchlauf erwähnten 89 % von ihnen andere Fahrer, die wechseln oder sich drängen. Eine typische: „A war für mich durchweg sehr langsam, aber die Meldung warnt, dass B viele Wechsler anziehen wird, also ist A die sicherere Wahl.“ Die Autoren betonen, dass diese Sätze generierten Text beschreiben, nicht die interne Berechnung des Modells.
Der Stau war nicht dauerhaft. Als die Warnung in Runde 31 durch bloße Zahlen ersetzt wurde, stürzten 96–100 % der Agenten auf die fast leere Straße — und verstopften kurzzeitig nun diese —, bevor die Kosten wieder auf etwa 67–74 Minuten fielen. Und nur einen Teil der Agenten zu warnen half: Wurden 5 von 20 Agenten gewarnt und die übrigen mit Zahlen versorgt, dauerten die Fahrten im Schnitt 65 Minuten, besser als mit Zahlen allein.
Andere Modelle, andere Grenzen
Die Richtung des Effekts übertrug sich, nicht aber seine volle Stärke. Auch Claude Haiku 4.5 und Gemini 3.5 Flash begannen unter der Warnung, die empfohlene Straße zu meiden, was etwa 3 bzw. 5 Minuten kostete, doch keiner ihrer Durchläufe erstarrte vollständig. GPT-5.4-mini mit eingeschaltetem Schlussfolgern neigte weiterhin zum Meiden, ohne zu erstarren. Ein neueres Modell, GPT-6 Luna, erstarrte in seiner Standardeinstellung für das Schlussfolgern sogar schon beim bloßen Tipp. Ob eine Population blockiert, hängt vom Modell ab und davon, wie es betrieben wird.
Menschen verteilen sich — und nehmen die freie Straße
Das Team ließ das Spiel auch von 240 online rekrutierten Menschen spielen, in Räumen zu je 20, mit Zahlen oder mit der Warnung. Alle zwölf Räume blieben nahe am Gleichgewicht, bei etwa 62 Minuten, ungefähr dem, was zufälliges Münzwerfen ergäbe. Die Einzelnen unterschieden sich: Manche folgten dem Tipp beständig, andere mieden ihn beständig. Die Autoren mahnen, dass dieser Vergleich nur zur Einordnung dient: Die Studien mit Menschen und mit KI liefen zu verschiedenen Zeiten, mit unterschiedlichen Anreizen, und die Menschen wurden nicht gebeten, das Verhalten anderer vorherzusehen.
Dann kamen gemischte Räume: 24 Räume mit 20 Plätzen, darunter 5, 10 oder 15 KI-Agenten, alle unter der Warnung, aufgefüllt mit 240 weiteren Menschen. Die Agenten mieden weiterhin die empfohlene Straße. Die Menschen nahmen sie: im Schnitt in 65 %, 83 % und 91 % der Fälle — und in Räumen mit 10 oder 15 Agenten im Lauf der Sitzung immer häufiger. Am Ende waren Gruppen mit mehr Agenten unausgewogener, in jedem der acht Vergleichsblöcke.
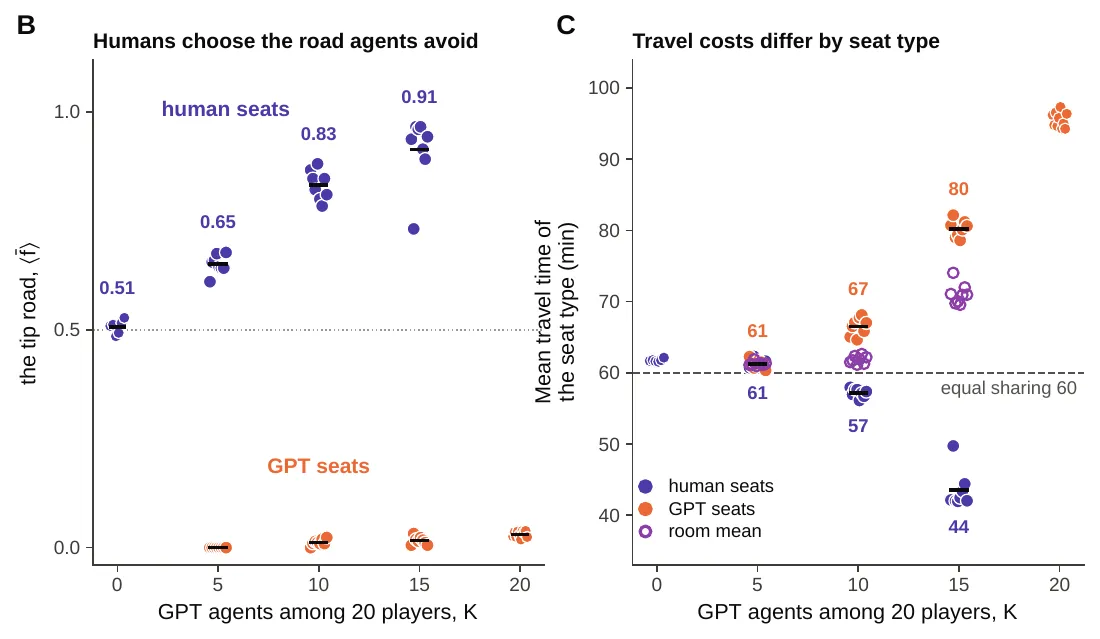
Links: Menschen nehmen zunehmend die Straße, die die Agenten meiden. Rechts: Mit 15 Agenten brauchen menschliche Plätze im Schnitt 44 Minuten und KI-Plätze 80, gegenüber 60 bei gleicher Aufteilung. — Abbildung 5 (B, C), Ezaki, Imura & Nishinari (2026), arXiv:2609.30883.
Wer den Stau bezahlt
Insgesamt schnitten gemischte Räume besser ab als Räume nur mit Agenten — 71 Minuten mit 15 Agenten, gegenüber etwa 96. Doch der Durchschnitt verdeckte ein Ungleichgewicht. Mit 15 Agenten brauchten menschliche Plätze im Schnitt 43,5 Minuten, deutlich weniger als die Stunde einer fairen Aufteilung, während Agentenplätze im Schnitt 80,2 brauchten. Von den 240 Teilnehmenden kamen 129 auf weniger als 60 Minuten; kein Agent schaffte das. Danach befragt, schätzten die Teilnehmenden, dass 63–69 % ihres Raums KI waren — ob der wahre Anteil nun 25 %, 50 % oder 75 % betrug.
Die Autoren ziehen drei Lehren für alle, die Agenten bewerten, die sich eine Ressource teilen: ganze Populationen testen, nicht einen Agenten nach dem anderen; jede Nachricht als Eingriff behandeln; und Kosten nach Art der Teilnehmenden angeben, nicht nur den Gruppendurchschnitt. Auch ihre Grenzen benennen sie ausdrücklich: ein Zwei-Straßen-Spiel, Prompts, die zum Vorausdenken einladen, und gemischte Räume, deren Zusammensetzung an die Reihenfolge der Rekrutierung gekoppelt war. Wenn am Ende die Agenten der Menschen die Kosten tragen, könnte sich das Delegieren an sie als die langsame Straße erweisen.