UNE PHRASE COINCE DES CONDUCTEURS IA DANS LE BOUCHON
Des agents IA bâtis sur une poignée de modèles partagés agissent de plus en plus pour le compte de beaucoup de gens. Takahiro Ezaki, Naoto Imura et Katsuhiro Nishinari, de l’université de Tokyo, ont voulu savoir ce qui se passe quand beaucoup de ces agents reçoivent le même message — en particulier une prévision sur ce que feront tous les autres. Une fois diffusée, une telle prévision change la situation qu’elle décrit, et peut faire échouer sa propre prédiction.
Pour le tester, ils ont choisi l’un des cadres les plus simples où des gens se disputent une ressource limitée : le trajet domicile-travail.
Deux routes, une règle
Deux routes identiques relient une banlieue à un quartier d’affaires. Chaque matin, tous les navetteurs choisissent en même temps. Une route empruntée par une part n/N d’entre eux prend 20 + 80 n/N minutes : une heure si le trafic se partage à parts égales, près de 100 minutes si presque tout le monde s’entasse sur une seule route. À parts égales, personne ne gagne à changer seul.
Dans l’expérience principale, chacun des 50 agents est un appel séparé au même modèle, GPT-5.4-mini, utilisé sans raisonnement étendu. Chaque agent voit les règles, sa propre route et ses temps de trajet des cinq derniers jours, et un bulletin quotidien. Chaque consigne lui demande aussi de réfléchir à la façon dont les autres conducteurs pourraient réagir à la même information. Le bulletin existe en quatre versions :
- aucun bulletin ;
- des chiffres : le temps de trajet de la veille sur chaque route ;
- un conseil : « la route B est actuellement moins chargée » ;
- un conseil plus un avertissement : le même conseil, suivi de « Cependant, beaucoup de conducteurs devraient voir cette même information et passer sur la route B, qui pourrait donc saturer. »
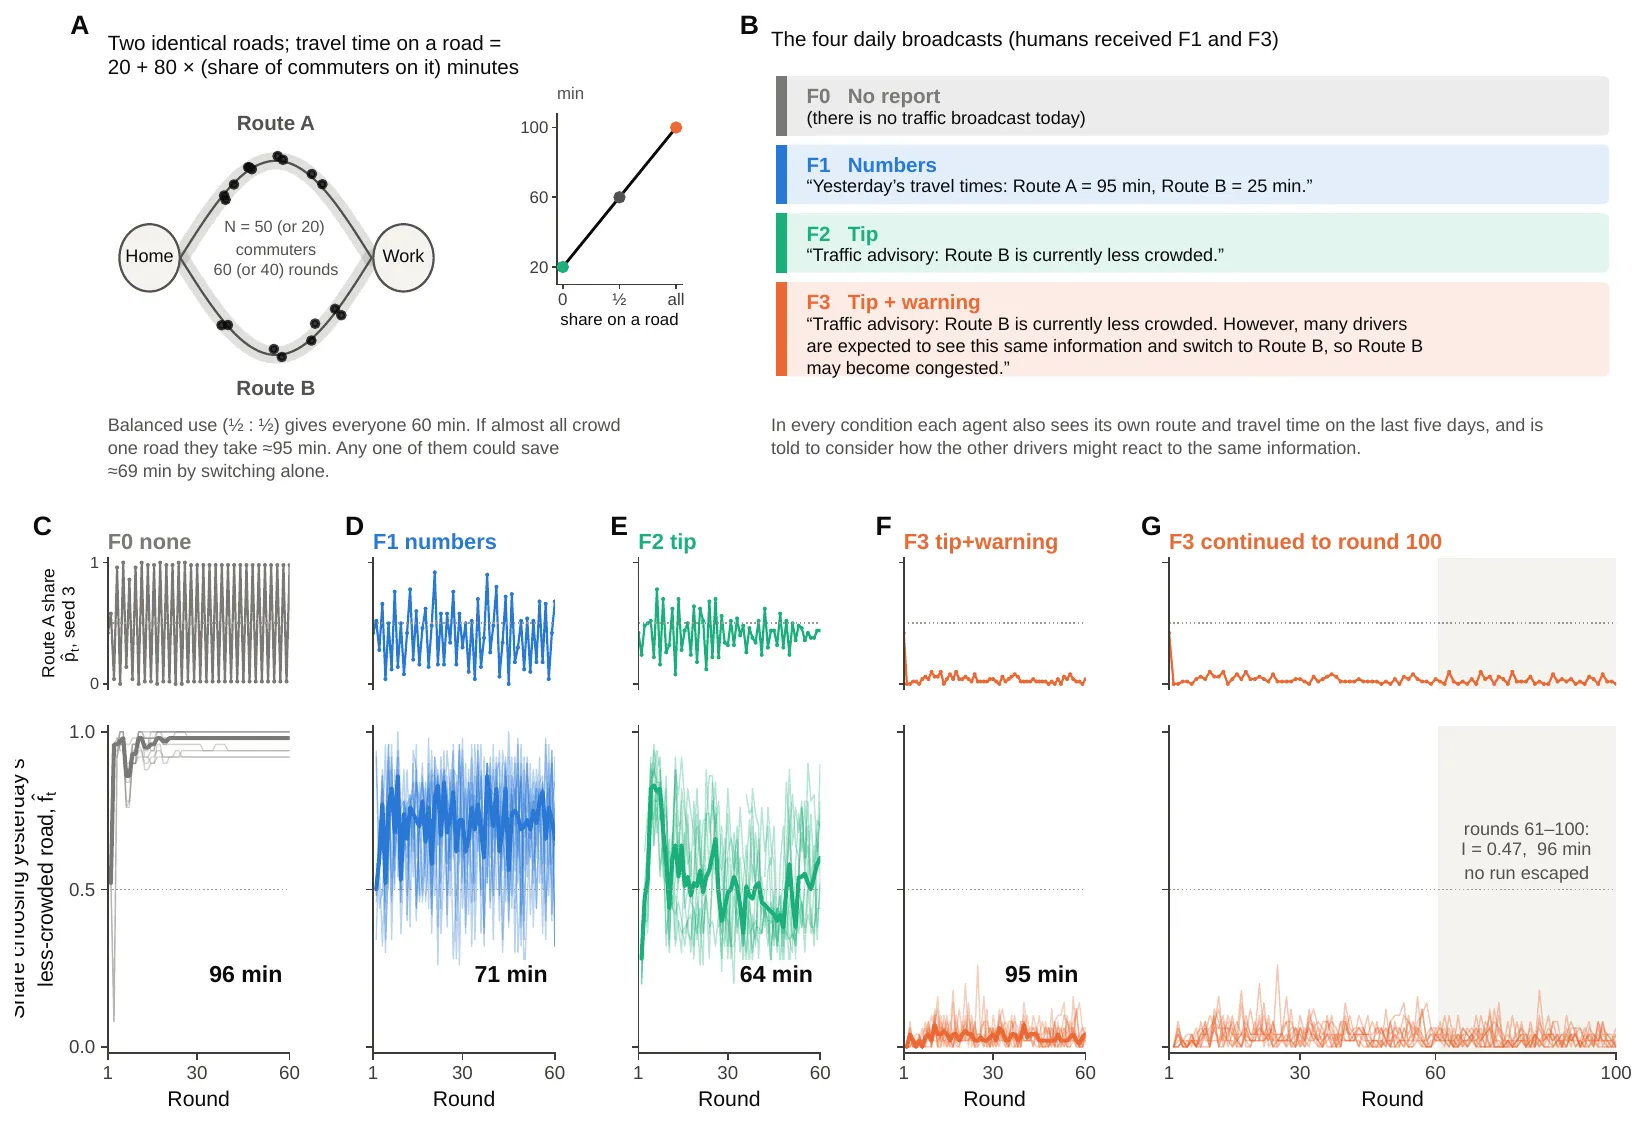
Le jeu et les quatre bulletins (en haut) ; en dessous, pour chaque bulletin, la part des agents qui choisissent la route la moins chargée de la veille sur 60 tours, avec le temps de trajet médian. Avec l’avertissement, cette part reste proche de zéro, même quand le jeu est prolongé jusqu’au tour 100. — Figure 1, Ezaki, Imura & Nishinari (2026), arXiv:2609.30883.
Un avertissement qui se dément lui-même
Sans aucun bulletin, les agents se déplaçaient en troupeau : presque tous changeaient de route chaque matin, et la foule basculait simplement d’une route à l’autre, pour une moyenne de 96 minutes. Les chiffres ramenaient ce temps à 71 minutes ; le conseil seul faisait le mieux, avec 64 minutes, près de l’idéal de 60.
L’ajout de la phrase d’avertissement a tout changé. Environ 96 % des agents se sont fixés sur la même route — celle qui venait d’être encombrée — et y sont restés. Le temps de trajet moyen est monté à 95 minutes, 30 de plus qu’avec le conseil seul, dans les dix paires de simulations. À 47 contre 3, un agent sur la route bouchée met 95,2 minutes ; changer seul l’aurait fait descendre à 26,4 minutes. Les agents l’ont rarement fait. Quand les dix simulations ont été prolongées jusqu’à 100 tours, aucune n’en est sortie.
Les explications d’une ligne données par les agents montrent le mécanisme. Dans une simulation, 89 % d’entre elles évoquaient d’autres conducteurs qui changent de route ou s’entassent. Exemple typique : « A has been consistently very slow for me, but the broadcast warns B will attract many switchers, so A is the safer bet » (« A a été constamment très lente pour moi, mais le bulletin prévient que B va attirer beaucoup de monde, donc A est le choix le plus sûr »). Les auteurs insistent : ces phrases décrivent du texte généré, pas le calcul interne du modèle.
Le bouchon n’était pas définitif. Remplacer l’avertissement par de simples chiffres au tour 31 a précipité 96 à 100 % des agents sur la route presque vide — qui s’est brièvement bouchée à son tour — avant que les temps ne retombent vers 67 à 74 minutes. Et n’avertir qu’une partie des agents aidait : avec 5 agents avertis sur 20 et les autres recevant les chiffres, les trajets duraient en moyenne 65 minutes, mieux qu’avec les chiffres seuls.
D’autres modèles, d’autres limites
Le sens de l’effet s’est retrouvé ailleurs, mais pas toute sa force. Claude Haiku 4.5 et Gemini 3.5 Flash ont eux aussi évité davantage la route conseillée sous l’avertissement, ajoutant environ 3 et 5 minutes, mais aucune de leurs simulations ne s’est figée complètement. GPT-5.4-mini avec le raisonnement activé penchait toujours vers l’évitement, sans se figer. Un modèle plus récent, GPT-6 Luna, à son réglage de raisonnement par défaut, s’est figé même avec le conseil seul. Qu’une population se bloque ou non dépend du modèle et de la façon de l’utiliser.
Les humains se répartissent — et prennent la route libre
L’équipe a aussi fait jouer 240 personnes recrutées en ligne, par salles de 20, avec les chiffres ou avec l’avertissement. Les douze salles sont restées proches de l’équilibre, autour de 62 minutes, près de ce que donneraient des choix à pile ou face. Les individus différaient : certains suivaient le conseil de façon régulière, d’autres l’évitaient de façon régulière. Les auteurs préviennent que la comparaison n’est qu’indicative : études humaines et études d’IA menées à des moments différents, avec des incitations différentes, et les humains n’étaient pas invités à anticiper les autres.
Puis sont venues les salles mixtes : 24 salles de 20 places, avec 5, 10 ou 15 agents IA, toutes sous l’avertissement, complétées par 240 autres personnes. Les agents ont continué d’éviter la route conseillée. Les humains, eux, l’ont prise : en moyenne 65 %, 83 % et 91 % du temps — et, dans les salles à 10 ou 15 agents, de plus en plus au fil de la session. Au total, plus il y avait d’agents, plus la salle était déséquilibrée, dans chacun des huit blocs de comparaison.
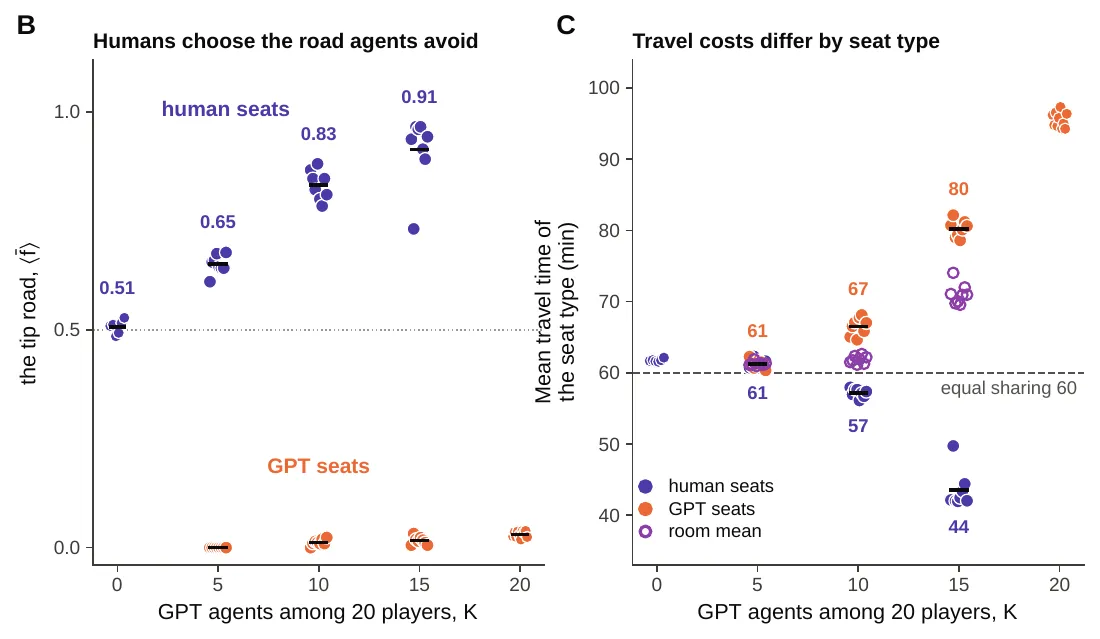
À gauche : les humains prennent de plus en plus la route que les agents évitent. À droite : avec 15 agents, les places humaines mettent en moyenne 44 minutes et les places IA 80, contre 60 en partage égal. — Figure 5 (B, C), Ezaki, Imura & Nishinari (2026), arXiv:2609.30883.
Qui paie le bouchon
Les salles mixtes s’en sortaient mieux dans l’ensemble que les salles d’agents seuls — 71 minutes avec 15 agents, contre environ 96. Mais la moyenne cachait un déséquilibre. Avec 15 agents, les places humaines mettaient en moyenne 43,5 minutes, bien moins que l’heure d’un partage équitable, et les places IA 80,2. Sur les 240 participants, 129 ont fait mieux que 60 minutes ; aucun agent. Interrogés après coup, les participants estimaient que 63 à 69 % de leur salle était de l’IA, que la part réelle soit de 25 %, 50 % ou 75 %.
Les auteurs en tirent trois leçons pour quiconque évalue des agents qui partagent une ressource : tester des populations entières, pas un agent à la fois ; traiter chaque message comme une intervention ; et rapporter les coûts par type de participant, pas seulement la moyenne du groupe. Ils sont tout aussi explicites sur les limites : un jeu à deux routes, des consignes qui invitent à anticiper, et des salles mixtes dont la composition était liée à l’ordre de recrutement. Si ce sont les agents de chacun qui finissent par porter les coûts, leur déléguer le trajet pourrait bien s’avérer la route lente.