LA SCIENCE COMMENCE-T-ELLE À SE RÉPÉTER ?
La littérature scientifique ne cesse de grossir — d’environ 4 % par an, doublant à peu près tous les 17 ans, d’après les chiffres cités dans l’article. Une littérature plus vaste pourrait signifier une frontière des idées plus large. Elle pourrait aussi signifier davantage d’articles qui répètent ce qui a déjà été écrit. Ilan Doron-Arad et Elchanan Mossel, mathématiciens au MIT, ont voulu mesurer un aspect de cette question.
L’originalité a de nombreuses dimensions et aucune mesure qui fasse consensus. Mais l’une d’elles se mesure désormais à grande échelle : la singularité textuelle, la part d’un article qui se lit comme des travaux récents. Les modèles de langage modernes peuvent transformer un passage en une liste de nombres qui capte son sens, si bien que deux passages disant la même chose avec des mots différents se retrouvent proches.
Les auteurs précisent avec soin ce que cela capte ou non. Une découverte réellement nouvelle peut s’écrire avec des phrases familières ; une tournure inhabituelle n’est pas une idée neuve.
Une comparaison à taille fixe
Une comparaison naïve serait trompeuse : à mesure que la littérature grossit, chaque passage a plus de chances de ressembler à quelque chose. Les auteurs ont donc gardé constant le réservoir de comparaison. Pour chacun de huit domaines — astrophysique, bio-informatique, chimie, changement climatique, apprentissage automatique, médecine, psychologie et informatique quantique — et chaque année de 2015 à 2025, ils ont pris 300 articles dans la base en accès libre CORE et les ont comparés à 3 000 articles des cinq années précédentes. Au total, environ 26 000 textes complets.
Chaque article a été découpé en passages de 160 mots qui se chevauchent. Une correspondance exigeait une forte proximité de sens, au moins six termes spécifiques communs, aucune suite identique de cinq mots — le simple copier-coller est donc exclu —, pas d’auteur commun, et pas deux versions du même article. Sur un jeu de test construit pour l’occasion, le détecteur ne faisait presque aucune fausse correspondance (précision de 99,6 %), tout en ratant certaines vraies.
Stable, puis une forte hausse
Jusqu’en 2020, la part du texte d’un article correspondant à des travaux récents tournait autour de 0,43 %. À partir de 2021, elle a grimpé, atteignant 1,34 % en 2025 — 3,1 fois le niveau antérieur. Un test statistique situe le début de la hausse en 2021.
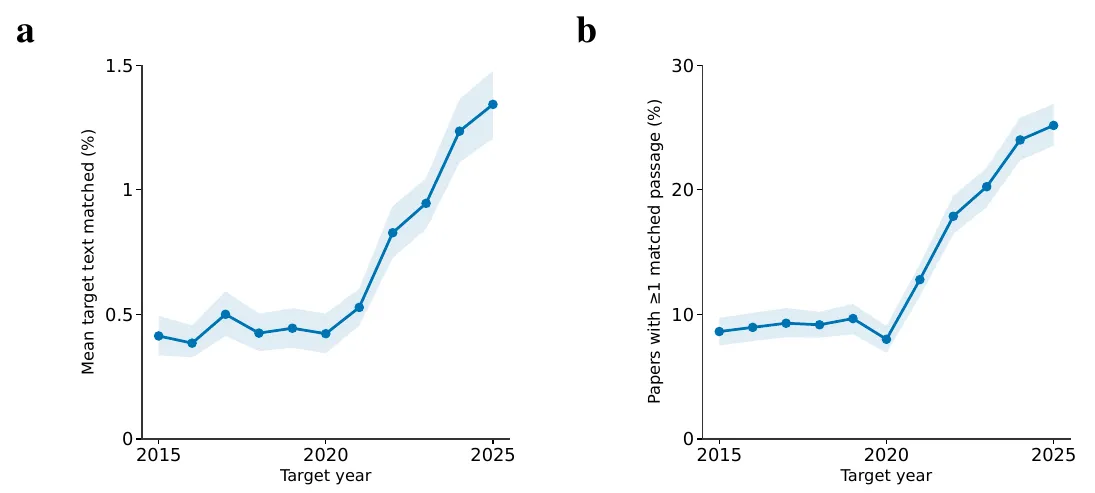
À gauche : part moyenne du texte de chaque article qui ressemble à des travaux récents. À droite : part des articles avec au moins un tel passage. — Figure 1a-b, Doron-Arad & Mossel (2026), arXiv:2609.32963.
La hausse ne vient pas de quelques gros emprunteurs. La part des articles contenant au moins un passage en écho a atteint 25 % en 2025. Les huit domaines ont tous augmenté, à des rythmes différents.
Des échos sans citations
Les auteurs citaient-ils simplement les travaux dont ils font écho ? Rarement. Un lien de citation n’a pu être trouvé que pour 6,4 % des paires d’articles appariées, et une vérification manuelle de 176 paires donne 7 %. Entre 2015 et 2025, les paires appariées sont passées de 449 à 1 831 — mais celles avec une citation sont restées à 59 les deux années.
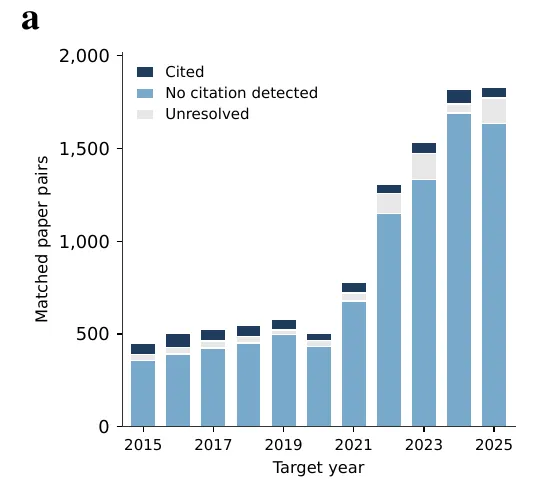
Nombre de paires d’articles appariées chaque année, selon la présence d’une citation : presque toute la croissance concerne des paires sans citation détectée. — Figure 3a, Doron-Arad & Mossel (2026), arXiv:2609.32963.
L’équipe s’est aussi demandé si ce sont les idées qui se répètent, pas seulement les mots. Des modèles d’IA d’Anthropic ont résumé chaque passage en quelques mots, puis jugé, sans voir le texte d’origine, si deux résumés exprimaient essentiellement la même affirmation scientifique. Avec une définition stricte, ces paires sont passées d’une moyenne d’environ 26 par an en 2015-2020 à 139 en 2025.
Le motif a résisté à de nombreuses vérifications — seuils différents, longueurs de passages, retrait des sections de méthodes et des sources les plus reprises — et s’est reproduit dans une seconde base indépendante, Europe PMC, où la part de texte en écho a doublé.
Un suspect, pas un verdict
La plus forte hausse coïncide avec l’adoption rapide des outils d’IA pour rédiger la science, et les auteurs y voient un facteur plausible, puisque ces outils tendent à diffuser les tournures les plus courantes. Mais l’étude n’établit pas la cause. Un langage disciplinaire commun et le resserrement de l’attention sur les mêmes quelques articles peuvent aussi jouer ; dans cette lecture, l’IA serait le dernier accélérateur d’une convergence déjà en cours. Les auteurs soulignent aussi que la similarité sémantique n’implique pas de faute.
Ils proposent des outils qui rendent l’originalité visible pour les auteurs, les relecteurs, les éditeurs et les financeurs — avec un avertissement : ne jamais faire d’un score de singularité un objectif, car il récompenserait la tournure inhabituelle plutôt que la vraie idée, et serait facile à truquer.